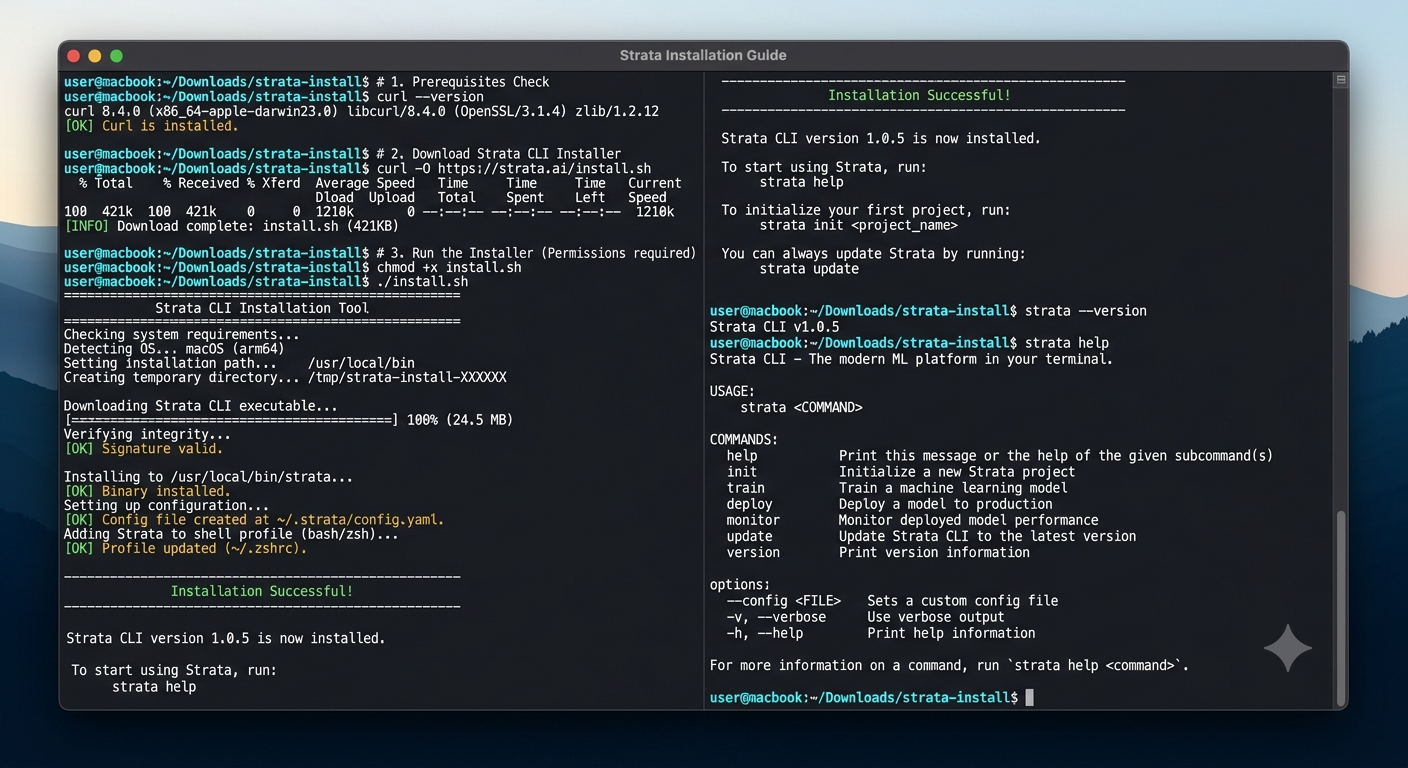
처음에 125B 모델을 RTX 4090 한 장에 올린다는 글을 보고 그대로 따라 했다가, PC가 3분 동안 멈춰서 강제 재부팅을 한 적이 있습니다. 원인은 VRAM이 아니라 시스템 RAM이었습니다. 이 글에서 왜 4090에서 돌아가는지, 실제로 어느 정도 속도가 나오는지, 그리고 실패 없이 세팅하는 기준을 정리했습니다.
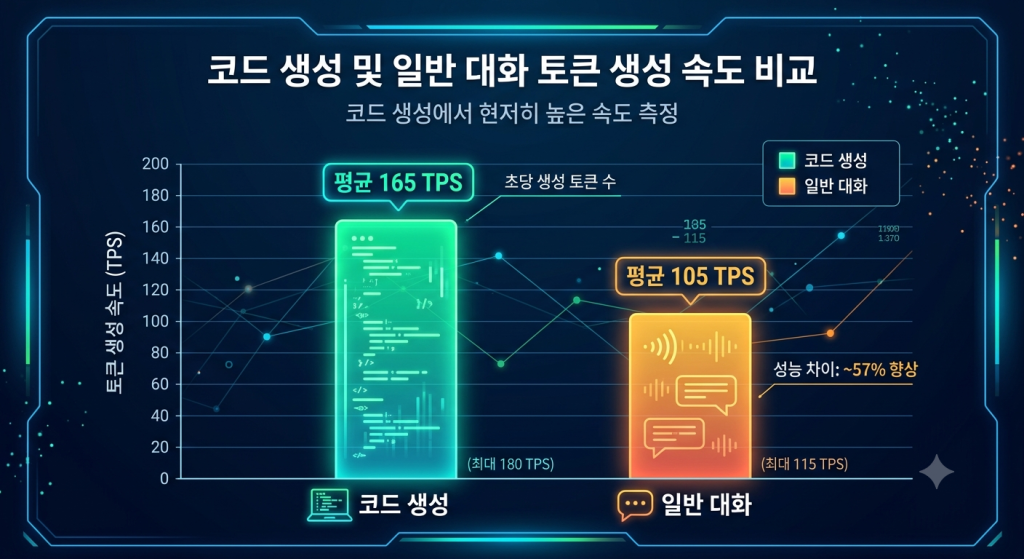
Qwen 3.8 Flash Next는 총 125B, 토큰당 활성 6B인 MoE 구조로 24GB VRAM에서 동작합니다. Strata 같은 런타임은 핫한 전문가만 VRAM에 두고 나머지를 RAM과 NVMe에서 스트리밍합니다. 코드·구조화된 출력에서 80~110토큰/초가 나오지만, 일반 대화는 더 낮게 체감됩니다.
Qwen 3.8 Flash Next는 무엇이 달라졌나
Qwen 팀이 공개한 3.8 Flash Next는 Qwen4 아키텍처의 얼리 프리뷰 성격입니다. 512개 전문가 중 10개를 라우팅하고 공유 전문가 1개를 더하는 MoE 구조, 36개 Gated DeltaNet 레이어와 12개 희소 어텐션 레이어 조합, 네이티브 262K 컨텍스트가 특징입니다.
파라미터 표기는 혼선이 있습니다. 학습 기준으로는 메인 모델 125B, n-gram 임베딩 테이블 약 51B, MTP 헤드 약 4B를 합쳐 180B로 설명되기도 합니다. 중요한 숫자는 토큰당 실제 연산량, 약 6B입니다. 실무에서 보면 이 활성 파라미터가 체감 성능을 결정합니다.
이 모델이 주목받는 이유는 단순 크기 때문이 아닙니다. 에이전트 코딩 벤치마크에서 Qwen3 27B 대비 평균 +4점 이상, DeepSWE 같은 에이전트 작업에서 42.2에서 58.7로 뛰는 결과가 나왔습니다. 로컬에서 에이전트 품질이 필요할 때 선택지가 생겼다는 의미입니다.
RTX 4090 한 장에서 돌아가는 원리
24GB 카드에 125B가 그대로 들어갈 수는 없습니다. 아이디어는 꽤 직관적입니다. 자주 쓰는 어텐션 가중치와 공유 전문가, 핫한 전문가만 VRAM에 상주시키고 나머지는 시스템 RAM에 둡니다. 필요할 때 PCIe로 스트리밍해서 가져오는 방식입니다.
여기에 두 가지 장치가 더해집니다. n-gram 임베딩 테이블은 행렬 곱이 아니라 조회 연산입니다. NVMe SSD에 둬도 속도 하락이 적습니다. 실제 배포 사례 중 47.7GB 양자화 테이블을 SSD에 두고도 디코딩 속도를 유지한 케이스가 있습니다. 두 번째는 멀티 토큰 예측과 스페큘러티브 디코딩입니다. 작은 헤드가 4토큰을 미리 쓰고 한 번에 검증합니다.
실무 팁: Strata 실행 시 –pcie-frac 0.35처럼 PCIe 대역폭 제한을 일부러 걸어두는 옵션이 있습니다. 대역폭을 다 쓰면 오히려 스터터가 생깁니다. 0.3~0.4 사이에서 안정성이 가장 좋았습니다. –kv int8와 –kv-resident 32768 조합은 250K 컨텍스트에서 OOM을 막는 핵심입니다.
이 부분이 핵심입니다. 온디바이스 LLM의 병목은 이제 VRAM이 아니라 RAM과 I/O 설계입니다. RAM이 저렴한 자원이라는 점을 이용해 VRAM 한계를 우회한 셈입니다.
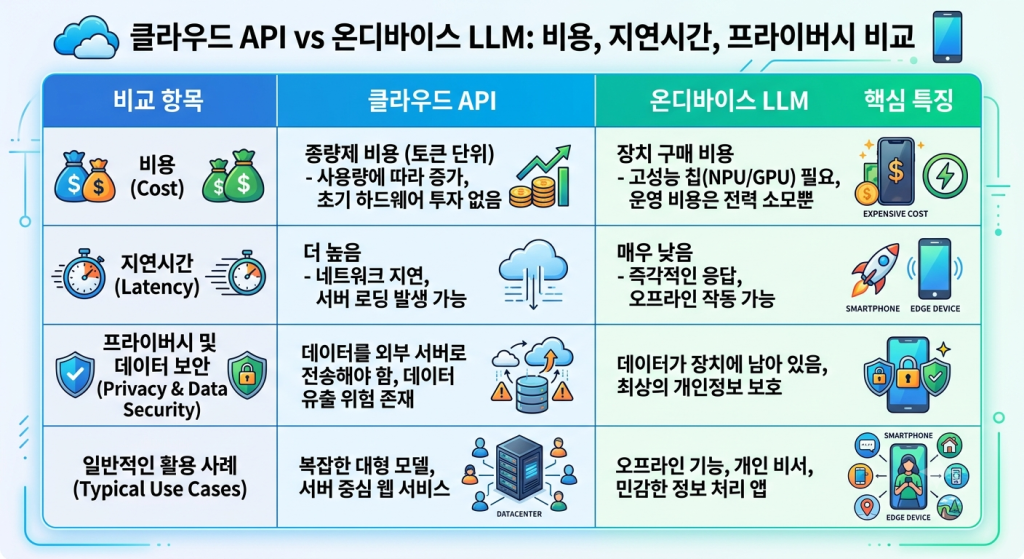
클라우드 vs 온디바이스 비교 분석과 선택 기준
클라우드가 무조건 싸거나, 로컬이 무조건 안전하다는 식으로 나누면 판단이 흐려집니다. 용도별로 갈립니다. 초보자가 실수하는 지점이 바로 여기, 무조건 로컬로 옮기면 비용이 0이 될 거라 기대하는 부분입니다.
| 구분 | 클라우드 API | 온디바이스 RTX 4090 + RAM 64GB |
|---|---|---|
| 초기 비용 | 0원 | GPU 약 220만원 + RAM 업그레이드 20~40만원 |
| 토큰 비용 | 1M 토큰당 약 1~3달러 | 전기료 외 0원, 월 200W 상시 기준 약 2~3만원 |
| 지연 시간 | 네트워크 왕복 300~800ms | 로컬 루프백 30~80ms, 첫 토큰은 250K 프롬프트 시 30~60초 |
| 프라이버시 | 외부 전송, 로그 정책에 의존 | 데이터 외부 유출 없음, 사내망 완전 격리 가능 |
| 확장성 | 동시 요청 자동 확장 | 단일 요청 최적화, 병렬 2 이상 시 토큰 속도 하락 |
당장 고객 데이터를 다루시나요? 그렇다면 로컬이 우선입니다. 반대로 하루 500만 토큰 이상을 불규칙하게 쓰면서 동시성이 중요하다면 클라우드가 아직 유리합니다. 실무자는 두 개를 섞습니다. 프로토타이핑과 민감 데이터 처리는 로컬, 대량 트래픽 서빙은 클라우드.
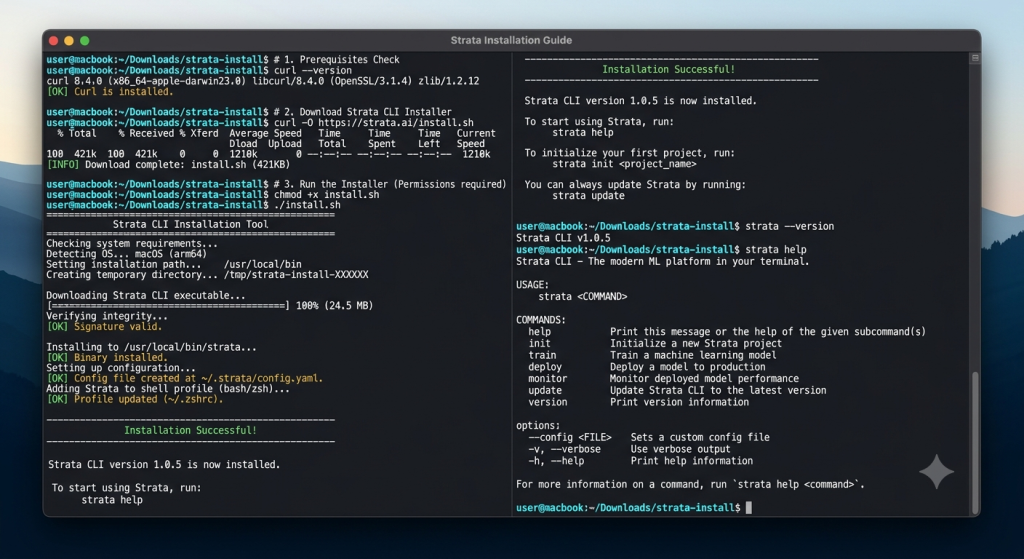
내 PC에서 돌리기 위한 체크리스트와 설치 과정
이건 직접 세팅해보면 바로 체감되는데, 생각보다 그래픽카드보다 RAM 구성이 결과를 좌우합니다. Strata 공식 가이드와 독립 벤치마크에서 제시하는 기준을 정리하면 아래와 같습니다.
| 시스템 RAM | 권장 양자화 | 체감 용도 |
|---|---|---|
| 32GB | Coder 변형 (전문가 절반 제거) | SWE-bench 기준 91% 성능 유지, 코딩 전용 |
| 48GB | IQ2_XS | 가벼운 테스트, 품질 저하 체감됨 |
| 64GB | IQ3_S | 밸런스 권장, 코드에서 80토큰/초대 |
| 96GB 이상 | UD-IQ4_XS | 품질 우선, 장문 컨텍스트 안정적 |
설치는 복잡하지 않습니다. 핵심만 추리면 이렇습니다.
- Ubuntu 22.04, 드라이버 560.xx, CUDA 12.3 이상으로 환경을 맞춘다.
- Python 3.11 venv를 만들고 torch 2.3 cu123 버전을 설치한다.
- Strata 리포지토리를 클론하고 pip install -e . 로 헬퍼를 설치한다.
- IQ3_S 팩을 다운로드한다, 전체 약 70GB이므로 NVMe 여유 공간을 확보한다.
- 첫 실행 시 35~55GB가 RAM에 로드되며 1~3분간 시스템이 멈춘 것처럼 보인다, 강제 종료하지 않는다.
- OpenAI 호환 엔드포인트 http://127.0.0.1:8080/v1 로 기존 클라이언트를 그대로 연결한다.
처음 하시는 분들이 여기서 많이 막히더라고요. llama.cpp를 쓴다면 2026년 8월 27일 이후 빌드여야 qwen4exp 아키텍처를 인식합니다. 그 이전 빌드는 unknown model architecture 에러로 바로 죽습니다.
실제 속도 100토큰의 의미와 체감 성능
100토큰/초라는 숫자는 마케팅처럼 들리지만 맥락이 있습니다. 독립 측정 리포에서 Ryzen 7900, DDR5 192GB, RTX 4090 280W 제한 환경에서 IQ3_S 기준 텍스트 디코드가 110.8토큰/초, 비전 포함 97.65토큰/초, 콜드 프리필 32K에서 4,750토큰/초가 나왔습니다.
반면 다른 개발자 측정에서는 MTP 없이 250K 컨텍스트에서 디코드 21토큰/초, 프리필 364토큰/초라는 보수적인 수치도 있습니다. 왜 차이가 클까요? 스페큘러티브 디코딩의 수락률 때문입니다. 산문에서는 0.59, 코드에서는 0.88, 구조화된 출력에서는 0.93까지 올라갑니다. 코드와 JSON 생성에서 체감 속도가 빠른 이유입니다.
실사용 기준으로 정리하면 이렇습니다. 짧은 Q&A나 요약은 클라우드와 체감 차이가 없습니다. 30K 토큰짜리 리포지토리 분석을 넣으면 첫 토큰까지 1분 가까이 걸립니다. 병렬 요청은 기본 OFF, parallel 2로 켜면 요청당 속도는 절반 이하로 떨어집니다.
오해와 진실
새 모델이 나올 때마다 반복되는 오해를 바로잡습니다.
오해 1: 4090이면 125B 전체가 VRAM에 들어간다
아닙니다. 활성 파라미터 6B만 매 토큰 연산에 사용됩니다. 나머지는 RAM과 SSD에 있고 필요할 때 스트리밍됩니다. 그래서 RAM이 32GB 이하면 Coder 변형만 쓸 수 있습니다.
오해 2: 100토큰/초가 모든 작업에서 나온다
코드와 구조화된 출력에서 수락률이 높아 그 속도가 나옵니다. 일반 대화, 추론 켠 상태, 긴 컨텍스트에서는 20~40토큰/초로 떨어질 수 있습니다. 벤치마크는 내 워크로드로 직접 해야 합니다.
오해 3: 양자화를 낮추면 품질이 비슷하다
Q2_0 같은 극저양자화는 RTX 5070에서 94토큰/초까지 나오지만 품질 하락이 큽니다. IQ3_S가 속도 53토큰/초대와 품질을 함께 잡는 실무 기본값으로 권장됩니다. Q2는 데모용, IQ3_S 이상이 프로덕션용으로 보는 게 맞습니다.
오늘 바로 실행할 수 있는 행동 1가지, 지금 PC RAM 용량을 확인하세요. 64GB 이상이라면 Strata IQ3_S 팩으로 코드 생성 테스트부터 시작하는 게 가장 리스크가 적습니다. 32GB라면 Coder 변형으로 시작하세요.
현재 주로 어떤 작업을 로컬로 옮기고 싶으신가요? 코드 자동완성, 사내 문서 요약, 고객 데이터 분류 중 어디에 가장 비용이 많이 들고 있나요?
만약 RAM 업그레이드를 고려한다면, 64GB와 96GB 중 어느 쪽이 더 현실적인 선택지인가요? 댓글로 환경을 남겨주시면 그 환경에 맞는 양자화 프리셋을 정리해 드리겠습니다.
다음에 읽으면 좋은 글: Strata vs Ollama vs llama.cpp 성능 비교와 세팅 최적화 방법, 64GB RAM 워크스테이션에서 80B MoE 모델 운영 시 꼭 확인할 BIOS와 커널 설정
본 포스팅은 정보 전달 목적이며, 실제 적용 시 발생하는 책임은 사용자에게 있습니다.